학생 교육에 필요한 내용이라서 보관을 위하여 작성함. 위키피디아에서 Public domain으로 공개된 파일임.

학생 교육에 필요한 내용이라서 보관을 위하여 작성함. 위키피디아에서 Public domain으로 공개된 파일임.
최신 모델에 대한 공부는 안했으나, 현재 진행중인 논문에서 사용한 이미지 학습 모델 중 DenseNet-161이 가장 성능이 좋아서 이를 이용하여 후속 논문을 진행할 예정이다. 따라서, DenseNet을 좀 배워보기로 했다. DenseNet과 관련된 논문은 다음과 같다.
arXiv preprint arXiv:1608.06993
이 쪽은 결과를 우선 내는 것을 중요시 하기 때문에 피어 리뷰를 하지 않는다. 뭐, 성능 검증이 되면 그게 바로 리뷰하고 승인일텐데 굳이 그런 형식에 얽매일 분야는 아니라고 본다. 전문 지식이 없어 블로그(https://wingnim.tistory.com/39)에서 정리된 내용을 내가 필요한 부분만 다시 정리하여 보았다.
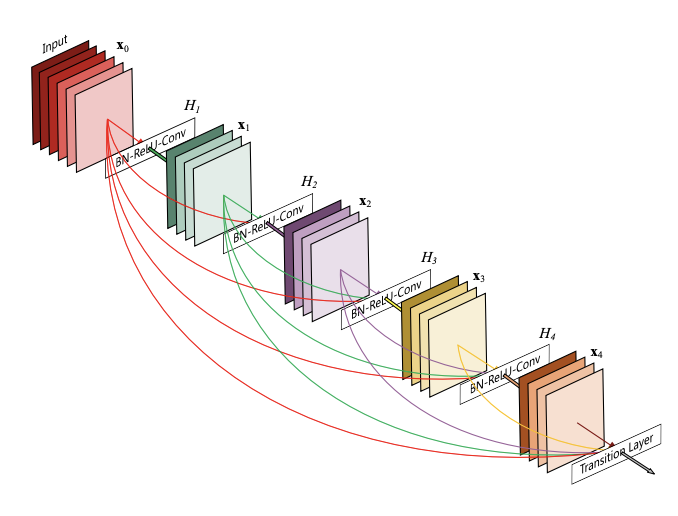
PyTorch에서 불러오는 방법은 다음과 같다. 애시당초 홈페이지에 당당하게 불러오는 방법이 안내되어 있다.
https://pytorch.org/hub/pytorch_vision_densenet/
무엇을 pretrained 했다는 것인지는 모르나, 알아 두어야 할 것은 다음이다.
from torchvision import transforms
preprocess = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])
이거는 이미지 변환과 관련된 부분인 것 같다. torchvision의 transforms를 이용한다. 따라서 자료를 찾아 보았다.
https://pytorch.org/docs/stable/torchvision/transforms.html
torchvision.transforms.Pad(padding, fill=0, padding_mode='constant')내가 필요한 것은 원하는 만큼 padding 하는 것이다. padding 항목 위치에 길이가 4인 tuple 형식으로 입력하면 왼쪽, 위, 오른쪽, 아래에 각각 채울 수 있다고 한다. fill=0은 기본값, constant는 그냥 채우는 것이다.
환자의 중증도를 평가하기 위해서는 보통 의무기록 검토를 통해서 각종 위험인자들을 파악한다. 그런데 심평원이나 건보공단같은 빅데이터 자료를 이용한 연구에서는 의무기록을 통한 위험인자를 파악할 수 없다. 혈액검사 결과가 기본적으로 없으니 검사 결과와 연동된 것도 할 수 없다. 이럴 때 이용할 수 있는 것이 Charlson Comorbidity Index (CCI)이다.
이전에 다른 연구를 통하여 CCI에 대하여 알게 되었다. 그 때에는 몰랐는데 나중에 다른 연구를 하면서 공동 연구자가 고혈압이 없는 것 같다는 이야기를 했었다. 그 때는 그냥 지나갔는데, 이번에 다른 연구자와 연구를 진행하게 되면서 내가 다른 연구원에게 해당 정보를 알려줄려고 하니 이 부분을 알아봐야 하겠다는 생각이 들었다. 그래서 관련 논문을 찾아 보았다.
https://pubmed.ncbi.nlm.nih.gov/3558716/
J Chronic Dis. 1987;40(5):373-83. doi: 10.1016/0021-9681(87)90171-8.
A new method of classifying prognostic comorbidity in longitudinal studies: development and validation
M E Charlson, P Pompei, K L Ales, C R MacKenzie
PMID: 3558716 DOI: 10.1016/0021-9681(87)90171-8
이 논문은 유방암 환자들의 1년 사망율을 예측하고자 한 것이었다. 그래서 여러 인자들에 대하여 분석을 하였다. 그리고 다른 코호트를 이용하여 10년간 생존 분석을 해보았고, 역시 유효한 결과를 얻었다.
고혈압은 처음에 분석 인자로 고려되었다. 하지만, adjusted relative risk가 낮아서 후속 분석 과정에서 빠지게 되었다.
기본적으로 가중치가 0, 1, 2, 3이상으로 분류하였다.
논문을 읽게 되면서 새로 알게 된 중요한 내용으로 나이가 있다. 나이 또한 매우 유의한 인자였기 때문에 이를 반영한 comorbidity-age combined risk score가 있다. 40대 이전은 0점이며 10년 단위로 1점씩 증가한다. 논문의 예시로 가중치 1점이 있는 60대는 3점이 되며, 가중치 3점이 있으면 5점으로 계산할 수 있다.
CNN에서 모델에 들어가는 이미지의 크기는 항상 일정해야 한다. 이미지의 크기가 작으면 요구하는 크기에 맞게 키워야 한다. 그 때 사용하는 방법이 사방을 0으로 둘러싸는 방법(zero-padding)과 비율에 맞게 키우는 방법이 있다. 이미지를 비율에 맞게 크게 하는 것은 어떤 방법에 따라서 임의의 값을 생성한다는 것이고 이를 보간법(interpolation)이라고 한다.
이 논문에서는 zero-padding과 interpolation 사이에 성능의 차이는 없다고 말하고 있다. 다만, zero-padding 된 부위가 계산 속도를 빠르게 해줄 수 있어서 더 좋지 않겠냐고 제시한다. 아직 이와 관련된 다른 이야기들은 찾기 못했다. 이와 같은 문제가 별로 상관이 없거나 아니면 작은 크기에 맞는 모델을 학습했다는 뜻이 아닐까 생각된다. 논문으로 쓸 만큼의 가치가 없는 것이 가장 적당한 이유가 아닐까 싶다.
Journal of Big Data. 2019;6(1):98.