Category: Python

  • Black

    파이썬에서 일관된 규칙으로 코드를 재작성 해주는 패키지. 버전 26.5.1 이라는 엄청난 높은 숫자를 보면 사람들의 수요를 알 수 있다. 😉

    짱 먹어라

    pip install black

    설치는 이렇게 하면 된다.

    현재 폴더 혹은 특정 파일에서 확인만 하려면 –check 를 붙인다.

    root@dd110323c5f5:~# black --check .
    All done! ✨ 🍰 ✨
    26 files would be left unchanged.

    –check 를 사용하지 않으면 변환시킨다

    주피터 노트북 파일을 변환시키려면 다음을 추가 설치한다.

    pip install "black[jupyter]"
  • ipynb-py-convert

    pip install ipynb-py-convert

    Jupyterlab 에서 작업한 파일을 py로 변환할 때 사용할 수 있다.

  • medgemma

    내 컴퓨터에서 실행할 수 있다는 양자화 모델을 이용해 보기로 했다.

    프로그램이 추천해 준 모델은 medgemma-1.5-4b-it 이다.

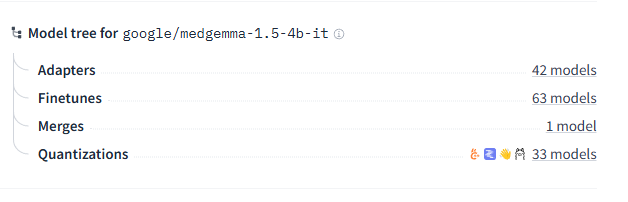
    이것을 그대로 이용할 수는 없다. 다른 사람들이 양자화시켜둔 것을 이용해야 한다고 한다.

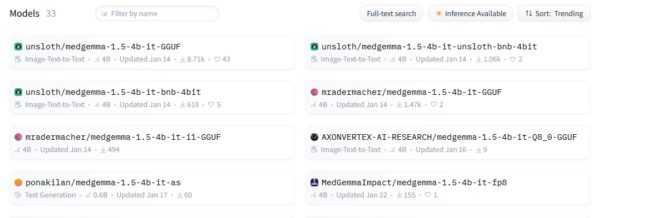
    마지막 중 Quantizations의 33 models를 클릭한다.

    첫 번째를 선택해 본다.

    Use this model 에서 ollama를 선택 한 후 모델을 지정한다. 처음 AI가 추천해 준 ollama run hf.co/unsloth/medgemma-1.5-4b-it-GGUF:Q5_K_M 를 이용해 본다.

    docker exec -it ollama ollama run hf.co/unsloth/medgemma-1.5-4b-it-GGUF:Q4_K_M

    Open WebUI 에서 파일을 읽어와도 된다. CLI 환경에서는 다음처럼 이용할 수 있다.

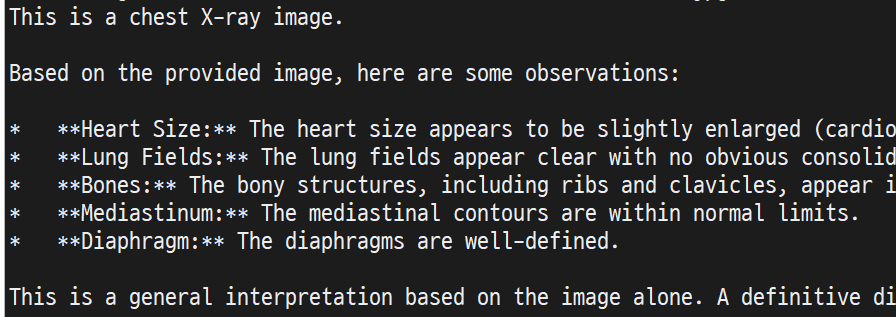
    docker exec -it ollama ollama run hf.co/unsloth/medgemma-1.5-4b-it-GGUF:Q4_K_M "Please read this X-ray /root/.ollama/001_00001.jpg"

    그럼 이렇게 결과가 나온다.

  • whichllm

    내 컴퓨터에서도 해봤다. 그랬더니 Qwen3-8B을 1번으로 추천했다. 내 RTX 3070 에서도 된다고 하니 Gemini에서 방법을 물어봐서 해보기로 했다.
    docker run -d --gpus=all \
      -v ./ollama:/root/.ollama \
      -p 11434:11434 \
      --name ollama \
      ollama/ollama

    이렇게 설치하고

    # Qwen3-8B 실행 (자동 다운로드 포함)
    docker exec -it ollama ollama run qwen3:8b

    이렇게 하면 된다.

    이거 신세상이다. 이용하기에 따라서는 매우 유용할 수도 있겠다.