Author: byun1114

  • 빅데이터 분석 도구 R 프로그래밍

    빅데이터 분석 도구 R 프로그래밍

    시대의 화두인 빅데이터. 관련 책을 하나 도서관에서 빌려 보았다. 그런데 빅데이터를 취급하지 않으니, 별로 와닿지는 않는다. 훑어본 결과 뒷부분에 있던 최적화와 관련된 내용이나 다중 프로세서의 사용이 더 와닿았음.

    최적화와 관련된 것은 아니지만, 속도 향상을 위해서는 벡터를 적극적으로 이용해서 계산을 하는 것이 좋다는 것이 있었음.

    다중 프로세서의 사용은 도대체 무슨 말인지 잘 모르겠음. 다만 핵심은 어떤 프로그램을 사용하던지 간에 일을 쪼개는게 필요한데, 이게 쉽지는 않다는 것이다. 내가 예전에 시도했던 방법은 정적 분산 컴퓨팅의 개념에 가깝다는 것은 확인할 수 있었다. 그 때에는 4등분 시켜서 하나의 터미널에서 실행 시켰는데, 그것도 분산 컴퓨팅의 하나의 방법인 정적 분산 컴퓨팅이 었다.

    필요한 부분을 스크랩해서 천천히 분석해가면서 읽어보면 될 듯 함.

  • 첫인상은 항상 배신한다.

    첫인상은 항상 배신한다.

    도서관 범죄학 책장에 있던 책으로 기억한다. 제목을 보고 있으니 재미있을 것 같아서 선택한 책. ‘크리미널 마인드’로 유명한 FBI 행동 분석반(BAU) 출신의 저자가 쓴 책이다. 범죄에 사용되곤 하는 프로파일링 기법을 일상 생활에서 이용하기를 바라는 마음에서 썼다고 한다.

    제목에서 나와 있듯이 선입견에 아주 중요한 역할을 하는 첫인상의 맹점에 대하여 다루고 있다. 그 뿐만 아니라 이성적인 사고 방식을 키워주는데에 도움이 되는 내용이 많이 있다. 내용도 어렵거나 잔혹하지 않음. 읽어보면 도움이 될 책이라고 생각한다. 

    ‘전과가 있습니까?’ 라는 질문에 대한 반응이 아주 도움이 된다는 저자의 팁은 적용해 볼만한 듯.

  • 왕은 어떻게 나라를 다스렸는가

    왕은 어떻게 나라를 다스렸는가

    도서관에서 제목이 재미있어서 고른 책. 삼국시대, 고려시대, 조선시대를 전공한 저자 3인이 각각 시대에 맞추어 왕의 리더십을 분석한 내용을 담고 있다. 국사 교과서에 등장하는 유명한 왕들에 대한 내용을 다루고 있으며, 다소 다른 시각에서 해당 사건을 바라보는 것이 많다. 저자들의 관점이 나와는 다른 부분도 다소 존재하며, 내가 거기에 대하여 비딱한 시선으로 바라보는지도 모르겠다는 생각이 들었지만, 그래도 내 생각은 다음과 같다.

    왕이 집권 세력에 대항하지 않는 것을 목표로 삼아야 한다 혹은 그러한 것을 염두해 두어야 한다고 기술하는 부분이 꽤 있다. 왕이 오래 살아서 집권을 오래하는 것도 있겠지만, 귀족 세력이나 다른 세력에 의하여 왕위를 박탈당하지 않도록 주의해야 한다는 부분도 꽤 인상적이었다. 왕은 약하거나 마음에 들지 않으면 언제든지 숙청당할 수 있는 존재로 묘사하고 있다. 신선한 발상이라고 생각되며, 왜 난 그 동안 그런 관점에서 바라보지 못했는가 반성할 정도임.

    왕이 후계자 지명에 대한 설명을 하는데 군사독재 정권 때를 예로 드는 부분이 있는데 이 부분은 좀 마음에 들지 않았다.

    통상적인 국사 교과서에서 기술하는 것과는 약간 다른 관점에서 사건을 기술하는 부분은 마음에 드는 부분도 꽤 있다.

    어떤 부분은 상당히 보수적인 과점에서 접근하는게 아닌가 하는 생각도 들었음.

    세종대왕에 대한 표현은 지나치다고 할 정도로 호의적임.

    집현전에는 학자 96명이 있었던 것으로 되어 있다고 함. 그 중에 과거 1등이 17명, 2등이 6명, 3등이 12명, 4등이 7명 정도로 구성되어 있다고 함. 대단할 정도로 똑똑한 사람들만 들어갈 수 있는 곳 이었음. 

  • EKG handling

    EKG handling

    EKG 에서 V1-V6 까지 QT interval 을 각각 측정해보라는 리뷰어의 지적을 받은 형의 부탁을 받아서 간단하게 QT interval 을 측정할 수 있도록 EKG 이미지를 다루어 보았다. 처음의 생각은 QT interval 까지 측정해 볼 수 있도록 좀 연구를 해볼려고 했는데, T wave가 약한 경우도 많고, 노이즈가 심한 경우도 있고, 전도 장애가 있는 것으로 기계 판독이 나온 경우도 있어서 결국엔 그것은 포기하고 수작업으로 QT interval 을 구하는 방법으로 하되, 그 구하는 과정이 용이하도록 이미지를 조작하는게 더 좋을 것이라는 결론에 이르렀다.

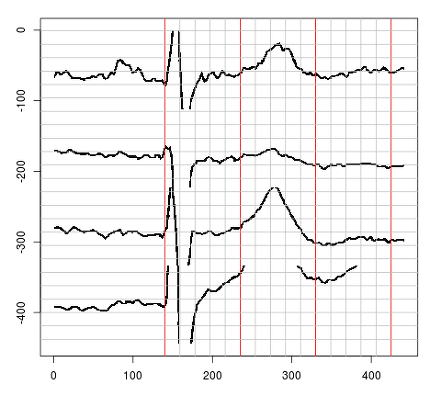
    지금 첨부한 그림은 가장 상단에 II, 그 아래로 V1 에서 V3 까지의 심전도를 약간 확대한 다음 QT 간격을 측정할 수 있을 만큼만 적당히 잘라서 붙인 것이다.

    이 과정에 사용한 패키지는 총 3개이다.

    파일명을 다루는데 사용한 stringr.

    PDF 파일을 PS 파일로 변환하고, 이 PS 파일을 다루기 위한 grImport.

    PS 파일을 PNG 파일로 변환해서 다루었기 때문에 PNG.

    원래 받은 심전도 이미지 파일은 PDF로 되어 있어서 직접 다룰 수가 없었기 때문에 적당한 변환 과정이 필요했다. 우선 리눅스 명령어 중에서 PDF2PS 를 이용하여 PS 파일로 변환하였으며, 이 이미지 파일을 R에서 2배의 크기로 출력한 후 PNG 파일로 저장했고, 이 이미지를 이용했다.

    통상의 3 x 4 심전도 출력물에서 각각의 심전도가 위치하는 위치는 고정되어 있기 때문에 적절한 영역을 지정해서 불러왔다. 그 다음 P 에서 T까지 하나의 심전도가 충분히 포함될 수 있도록 중간 부분만을 선택했다.

    Lead II 에서는 특징적이라고 할 수 있는 위쪽으로 높은 QRS complex 가 관찰이 되며, 이를 수식으로 찾는것이 가장 쉬울 것이라고 생각했다. 그래프를 분석한 것이 아니라, 각각을 구성하고 있는 점을 기반으로 수식으로 구현하기로 했다. 정상적인 경우라면 R파의 Y축의 값이 거의 항상 최고 값을 가지기 때문에, 이를 기준으로 R 의 위치를 추정할 수 있는 지점을 선택할 수 있다. 이 지점들 앞쪽 부근에서 일정 간격으로 기울기를 구하여 기울기가 일정 범위 이상으로 꾸준히 관찰되는 첫 번째 지점을 Q 파에서 R 로 넘어가는 부분으로 지정하기로 하였다. 이 방법은 꽤나 많은 증례에서 꽤 괜찮은 정도로 Q를 찾아 주었다. Q를 찾았으면 이 위치를 기준으로 나머지 V1에서부터 V3까지 같은 지점을 잘라서 붙이면 된다.


    이 알고리즘으로 구할 수 없는 경우를 보면 대부분 left axis deviation 이라는 기계 판독이 나온 경우가 대부분이었다. QRS 의 진폭이 T 보다 작게 나올 경우에도 이 방법을 적용할 수는 없었다.

    RStudio Server 버젼을 설치한 이후 처음을 지속적인 계산이 필요한 작업이었는데, 빠른 컴퓨터로 작업을 할 수 있는 장점을 십분 활용할 수 있어서 좋았다.