Category: Python

  • DenseNet

    최신 모델에 대한 공부는 안했으나, 현재 진행중인 논문에서 사용한 이미지 학습 모델 중 DenseNet-161이 가장 성능이 좋아서 이를 이용하여 후속 논문을 진행할 예정이다. 따라서, DenseNet을 좀 배워보기로 했다. DenseNet과 관련된 논문은 다음과 같다.

    arXiv preprint arXiv:1608.06993

    이 쪽은 결과를 우선 내는 것을 중요시 하기 때문에 피어 리뷰를 하지 않는다. 뭐, 성능 검증이 되면 그게 바로 리뷰하고 승인일텐데 굳이 그런 형식에 얽매일 분야는 아니라고 본다. 전문 지식이 없어 블로그(https://wingnim.tistory.com/39)에서 정리된 내용을 내가 필요한 부분만 다시 정리하여 보았다.

    • ResNet은 중간중간마다 이전의 결과를 받아오는 방법을 이용하였다면, DenseNet은 이전 정보들이 더 깊은 레이어까지 정보를 전달하는 방법이다. 그래서 네트웍이 조밀해(dense)진다.
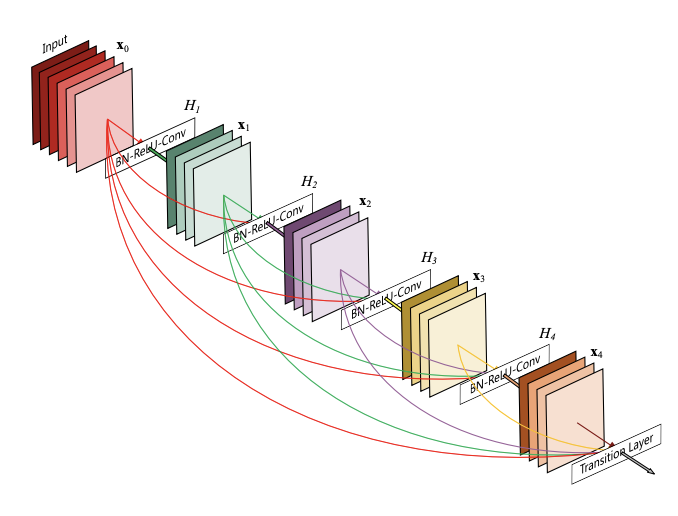
    https://pytorch.org/assets/images/densenet1.png

    PyTorch에서 불러오는 방법은 다음과 같다. 애시당초 홈페이지에 당당하게 불러오는 방법이 안내되어 있다.

    https://pytorch.org/hub/pytorch_vision_densenet/

    무엇을 pretrained 했다는 것인지는 모르나, 알아 두어야 할 것은 다음이다.

    • 3-channel RGB (3 x H x W)
    • H와 W는 최소 224 pixels
    • 값은 [0, 1]로 되도록 변환
    • normalization 시행함.
    from torchvision import transforms
    preprocess = transforms.Compose([
        transforms.Resize(256),
        transforms.CenterCrop(224),
        transforms.ToTensor(),
        transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
    ])

    이거는 이미지 변환과 관련된 부분인 것 같다. torchvision의 transforms를 이용한다. 따라서 자료를 찾아 보았다.

    https://pytorch.org/docs/stable/torchvision/transforms.html

    torchvision.transforms.Pad(padding, fill=0, padding_mode='constant')

    내가 필요한 것은 원하는 만큼 padding 하는 것이다. padding 항목 위치에 길이가 4인 tuple 형식으로 입력하면 왼쪽, 위, 오른쪽, 아래에 각각 채울 수 있다고 한다. fill=0은 기본값, constant는 그냥 채우는 것이다.

  • Enlarging smaller images before inputting into convolutional neural network: zero-padding vs. interpolation

    CNN에서 모델에 들어가는 이미지의 크기는 항상 일정해야 한다. 이미지의 크기가 작으면 요구하는 크기에 맞게 키워야 한다. 그 때 사용하는 방법이 사방을 0으로 둘러싸는 방법(zero-padding)과 비율에 맞게 키우는 방법이 있다. 이미지를 비율에 맞게 크게 하는 것은 어떤 방법에 따라서 임의의 값을 생성한다는 것이고 이를 보간법(interpolation)이라고 한다.

    이 논문에서는 zero-padding과 interpolation 사이에 성능의 차이는 없다고 말하고 있다. 다만, zero-padding 된 부위가 계산 속도를 빠르게 해줄 수 있어서 더 좋지 않겠냐고 제시한다. 아직 이와 관련된 다른 이야기들은 찾기 못했다. 이와 같은 문제가 별로 상관이 없거나 아니면 작은 크기에 맞는 모델을 학습했다는 뜻이 아닐까 생각된다. 논문으로 쓸 만큼의 가치가 없는 것이 가장 적당한 이유가 아닐까 싶다.

    Journal of Big Data. 2019;6(1):98.

  • .rand 와 .randn

    교재를 따라서 계속 실습하고 있는데 결과가 심하게 차이가 나서 무엇이 원인인지 찾아보았다. 실행을 덜 시켜서 그런가 싶어 끝까지 실행해 봤는데도 모르겠고, 오타가 있는지, 들여쓰기는 잘 되었는지 확인해 보아도 찾지를 못했다. Github에서 제공 코드를 받아서 실행해 봤더니 이건 또 실행이 잘 되었다. 그래서 코드를 출력한 다음에 하나하나 확인해 보았다. 그 결과 .randn으로 해야 할 것을 .rand 로 되어 있을 것을 알게 되었다.

    .randn은 평균이 0이고 분산이 1인 난수 생성할 때에 사용한다.

    .rand은 0에서 1사이에 균일한 난수를 생성할 때에 사용한다.

  • Hyperparameters

    Hyperparameters
    예시에서 사용하는 모델 층의 종류와 크기, 배치 크기, 학습률 등 머신러닝 모델이 매우지 않고 사용자가 직접 지정해주는 값을 ‘하이퍼파라 미터’라고 합니다. 모델의 가중치(파라미터)를 최적화하는데 많은 영향을 주게 됩니다. 따라서 이 하이퍼파라미터를 최적화하는 것도 딥러닝 에서 데이터를 모으는 과정만큼이나 중요합니다.