
라즈베리파이에서 사용할 액정을 납땜하여 보았다.
사실 납땜 자체는 많이 어려운 것이 아니었다. 몇 번 해보니 요령이 생겨서 비교적 쉽게 할 수 있었다. 전반적으로 바깥쪽으로 기울여진 상태로 되기는 했지만 적어도 전원 부분에 관련된 4개는 제대로 연결이 된 것을 확인할 수 있었다.
그리고 그 다음으로 깨달은 것은 액정에 글자를 보이게 하는 것은 보통일이 아니라는 것이다. 아무래도 천천히 하나씩 검토해 보아야 할 듯하다.

라즈베리파이에서 사용할 액정을 납땜하여 보았다.
사실 납땜 자체는 많이 어려운 것이 아니었다. 몇 번 해보니 요령이 생겨서 비교적 쉽게 할 수 있었다. 전반적으로 바깥쪽으로 기울여진 상태로 되기는 했지만 적어도 전원 부분에 관련된 4개는 제대로 연결이 된 것을 확인할 수 있었다.
그리고 그 다음으로 깨달은 것은 액정에 글자를 보이게 하는 것은 보통일이 아니라는 것이다. 아무래도 천천히 하나씩 검토해 보아야 할 듯하다.
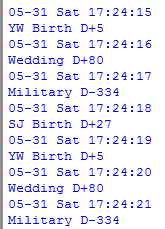

D-day 기능과 NTP를 통한 시간의 동기화 기능이 구현된 시계가 있었으면 좋겠다고 예전부터 생각’만’ 하고 있다가 라즈베리파이로 구현해 보기로 마음을 먹었다.
라즈베리파이에서도 R이 구현 가능할 것 같기는 했는데, 그 보다도 액정에 글을 뿌려주는게 python 으로 구현되어 있는걸 쓰는게 일반적인듯 했다. 그래서 python 으로 구현해야만 했다.
R과는 조금은 다른 문법 구조와 체계 때문에 인터넷 검색을 여러번 해본 끝에 비슷하게 구현하는데 성공했다. 이제 남은 것은 코드를 조금 더 최적화시키고, 생각해둔 기능을 추가로 구현시켜서 쓰는 것이다.
필요는 발명의 어머니라고 누가 말했던가..
병리과 논문 뿐만이 아니라, 대부분의 연구에서는 두 그룹사이에서 각종 인자의 비교가 필수적이다. 병리과에서는 대부분의 인자가 2개 혹은 그 이상의 ordinal factor 로 구성되어 있다. 그렇다는 것은 chi-squre 검정을 선택하던가 혹은 fisher 검정을 선택해서 검사를 시행하여야 한다는 것을 의미함.
처음에 함수 구성은 비교 항목을 나열하고 그에 따라서 비교하는 부분을 일일이 넣어줬다. 그다지 나쁜 방법은 아니지만, 변경이 있을 경우에 일일이 고쳐줘야 하며 빼먹는 부분도 생기게 마련이다. 그래서 두 항목의 비교만을 다루는 함수를 사전에 만들고, 그 다음에는 각각의 비교 인자에 따라서 비교를 시행하는 함수를 하나 더 만드는 방법으로 시행하기로 하였다.
여러번 분석을 하다보니 한 줄(column)이나 열(row)에 0으로 가득찬 값이 있으면 통계 분석을 시행하지 못하고 오류메세지와 함께 비교 과정이 중단되기 때문에 이에 대한 것을 확인하는 과정이 필요했다.
반복구문이 많아지면 실행 속도가 느려지기는 하지만, 뭐 그렇게 CPU나 나쁜 것도 아니고, 내가 복잡한 계산을 수행하는 것도 아니기 때문에 반복 구문을 최대한 활용하기로 하였다.
compare.fun <- function(parameter.1, parameter.2){
A <- parameter.1
B <- parameter.2
#Matrix 의 Cell 숫자
cell.number <- nrow(table(A, B)) * ncol(table(A, B))
#한 줄 혹은 한 열에 0 으로 가득찬 경우가 있으면 find.0 라는 값에 1을 더하기.
find.0 <- 0
for (X in 1:nrow(table(A, B))){if (length(which(table(A, B)[X, ] == 0)) == ncol(table(A, B))) {find.0 <- find.0 + 1}}
for (X in 1:ncol(table(A, B))){if (length(which(table(A, B)[, X] == 0)) == nrow(table(A, B))) {find.0 <- find.0 + 1}}
# 한 번이라도 0으로 가득찬 경우가 있으면 일단 계산 수행은 안하는 것으로, 그렇지 않을 경우 계산 수행. Fisher 검정의 조건을 만족하면 Fisher 검정을 그렇지 않다면 chi-squre 검정 수행. 각각의 검정 수행 후 correlation 검사 수행.
ifelse(find.0 > 0, NA,
if (length(which(table(A, B) <= 5)) > 0 & (length(which(table(A, B) <= 5)) / cell.number >= 0.25)) {
print(fisher.test(A, B))
print(cor.test(A, B, method=”spearman”))
} else {print(chisq.test(A, B, correct=FALSE))
print(cor.test(A, B, method=”spearman”))
}
)
# 사실 함수 내부에서 만든 값은 내부에서만 사용되기 때문에 다음의 항목은 필요없지만 그래도 넣었음.
rm(A, B, cell.number, find.0)
# 중간에 여러줄을 띄우면 구분이 쉽다.
cat(rep(“\n”,3))
}


